 Mixer AI




Cómo hacer tu gemelo digital: una copia de ti en fotos y video
Un doble con IA, o clon de ti mismo con IA, es tu cara y tu aspecto manteniéndose de un fotograma a otro en fotos y video, más tu voz. Se crea con una hoja de personaje hecha con tus propias fotos, que se adjunta como referencia a cada generación: no se entrena ningún modelo con tu cara, así que el parecido depende de las fotos de partida.
Más
¿Necesitas un avatar que habla a partir de una foto y una grabación de voz? Es otra guía: Cómo hacer un video con avatar IA a partir de una foto y tu voz.
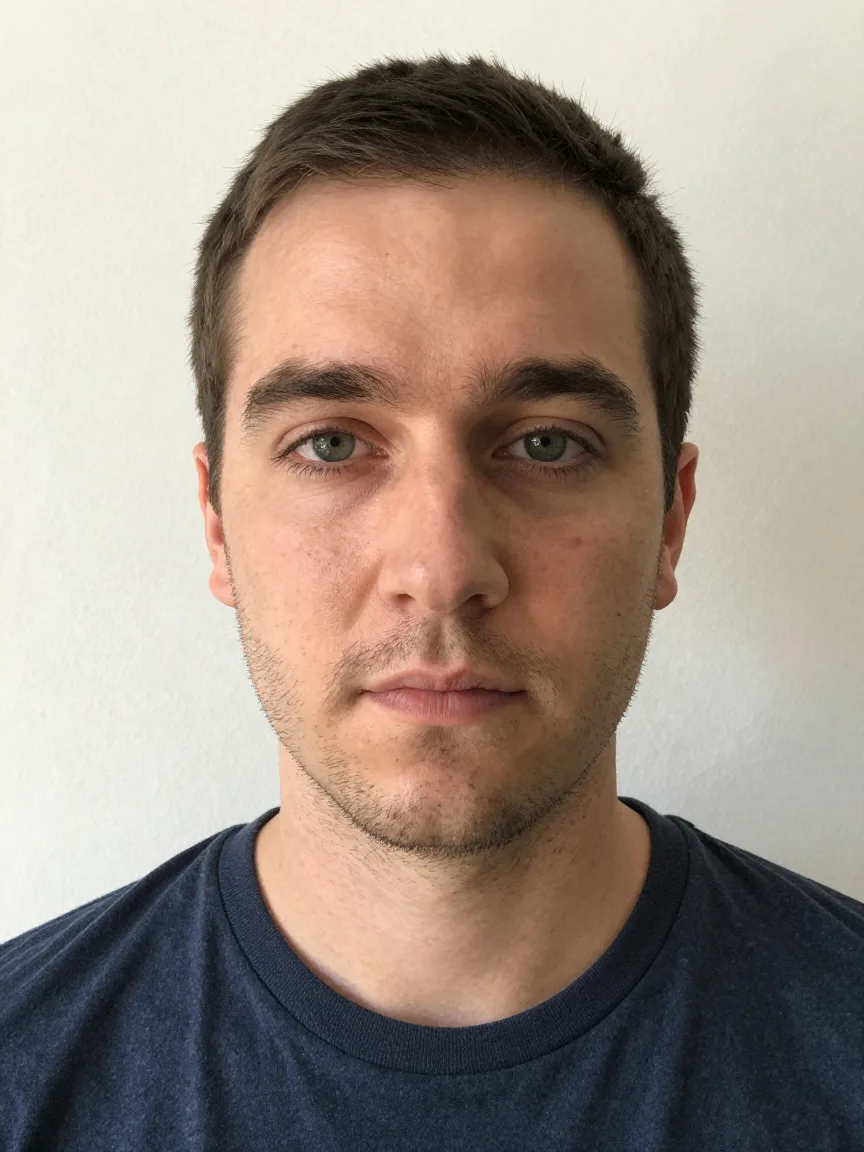
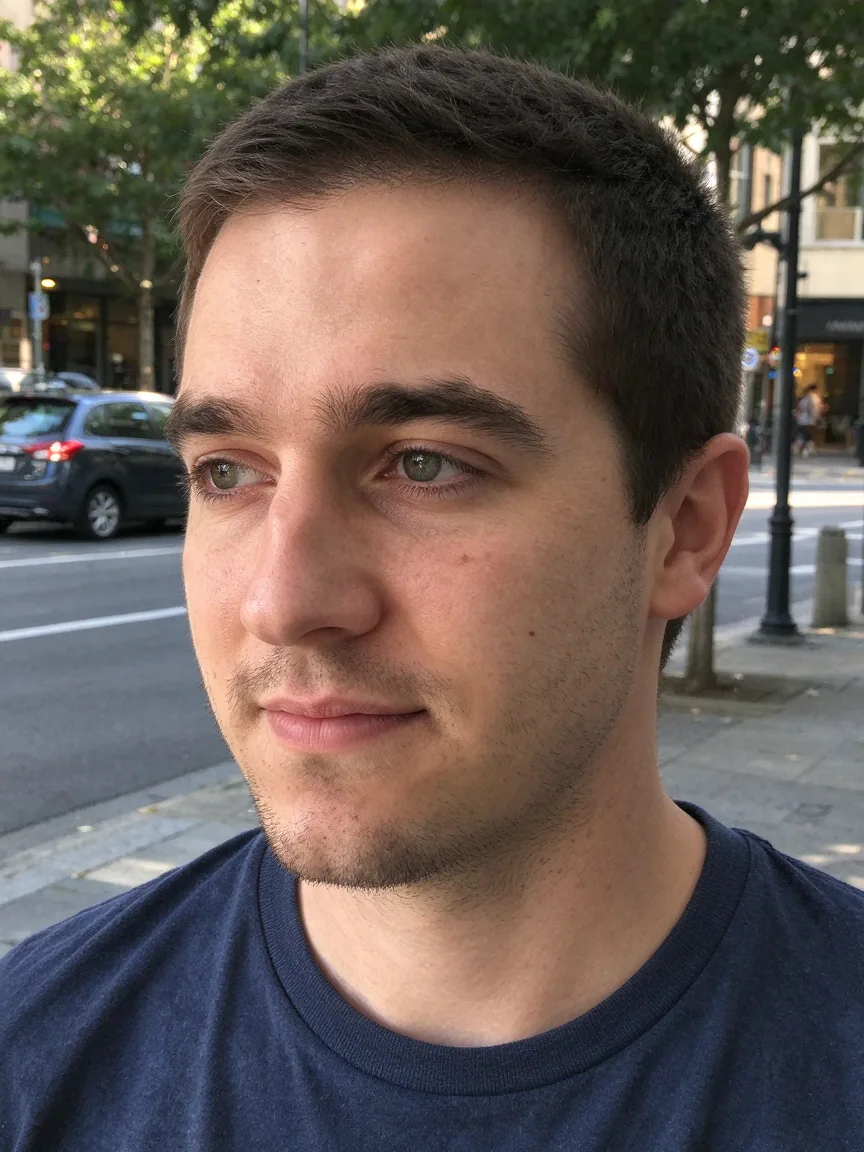
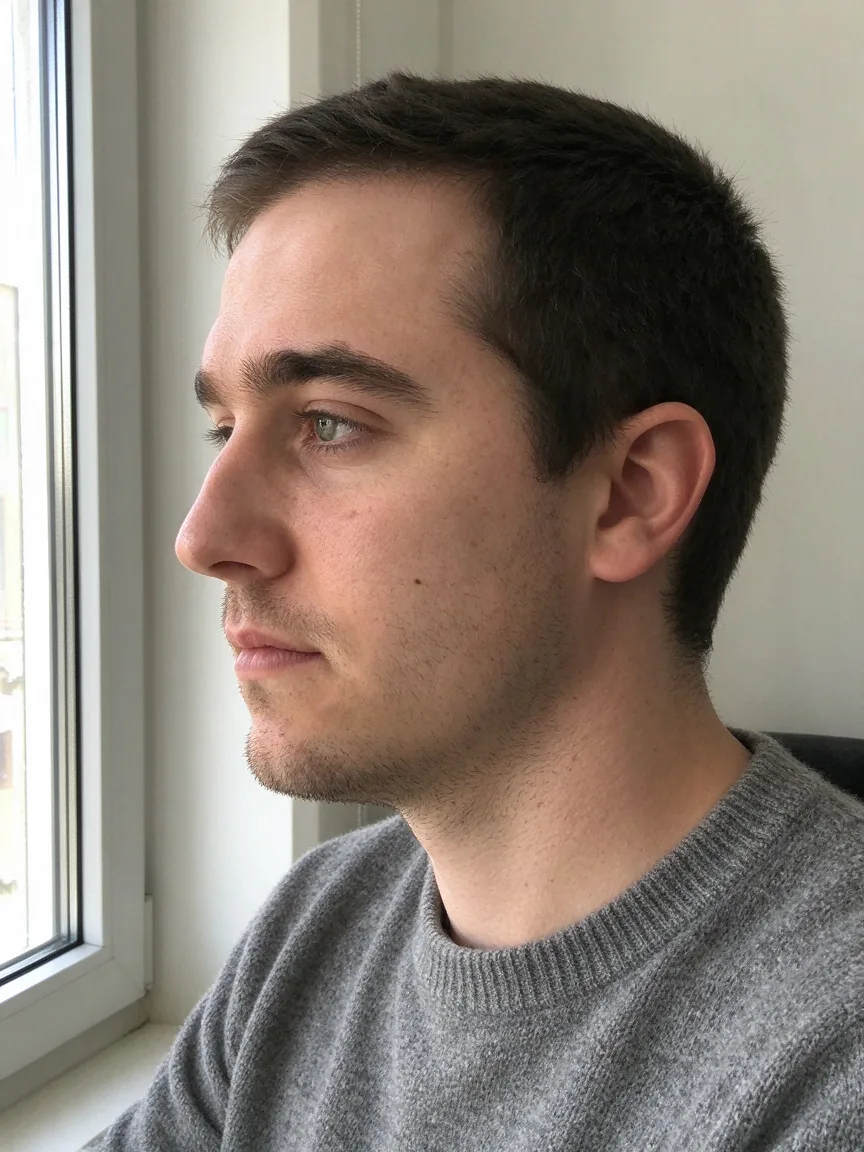
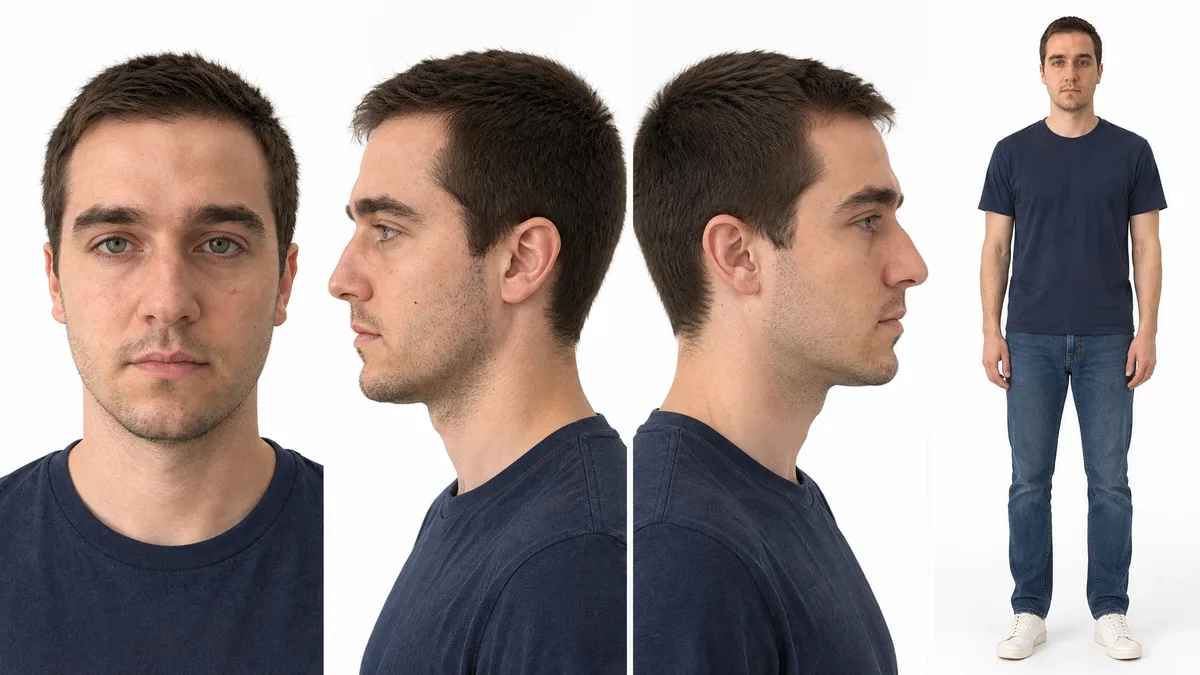
Hoja de personaje basada en las imágenes 1–3: la misma persona en cuatro vistas — retrato de frente, perfil izquierdo, perfil derecho, cuerpo entero. Fondo blanco limpio, luz suave y uniforme, fotorrealista, expresión neutra. Conservar los rasgos, la forma de la nariz, el color de ojos, el nacimiento del pelo, los lunares y las pecas como en las fotos originales. No embellecer la cara, no cambiar la edad, sin accesorios ni texto.
Paso a paso
Haz las fotos con luz de día uniforme: un retrato de frente con expresión neutra, un perfil y una de cuerpo entero.
Sin gafas ni gorra; si importa un lunar o una cicatriz, añade un primer plano.
Crea la hoja de personaje en GPT Image 2.6 o Nano Banana Pro: sube tus fotos y pide tres o cuatro vistas de la misma persona sobre fondo blanco.
Compárala contigo y repítela si cambian la nariz, los ojos o el nacimiento del pelo.
Para una serie de fotos, adjunta la hoja a cada imagen y describe solo la escena, la luz y la pose.
Haz cada imagen nueva desde la hoja, no desde el resultado anterior.
Para video, elige Seedance 2.5 o Wan 3.0 en modo por referencias y sube la hoja y una foto del lugar.
En el prompt nombra los papeles (imagen 1 es la cara y la ropa del protagonista, imagen 2 es la calle) y el número de personas en el encuadre.
Para que tu doble hable con tu voz, graba entre 2 y 15 segundos de habla en una habitación silenciosa y añádelos como referencia de audio en Seedance 2.0 o 2.5, Wan 3.0 o MiniMax H3.
En el prompt escribe habla con la voz del audio 1 y la frase entre comillas.
Prompts para un doble digital
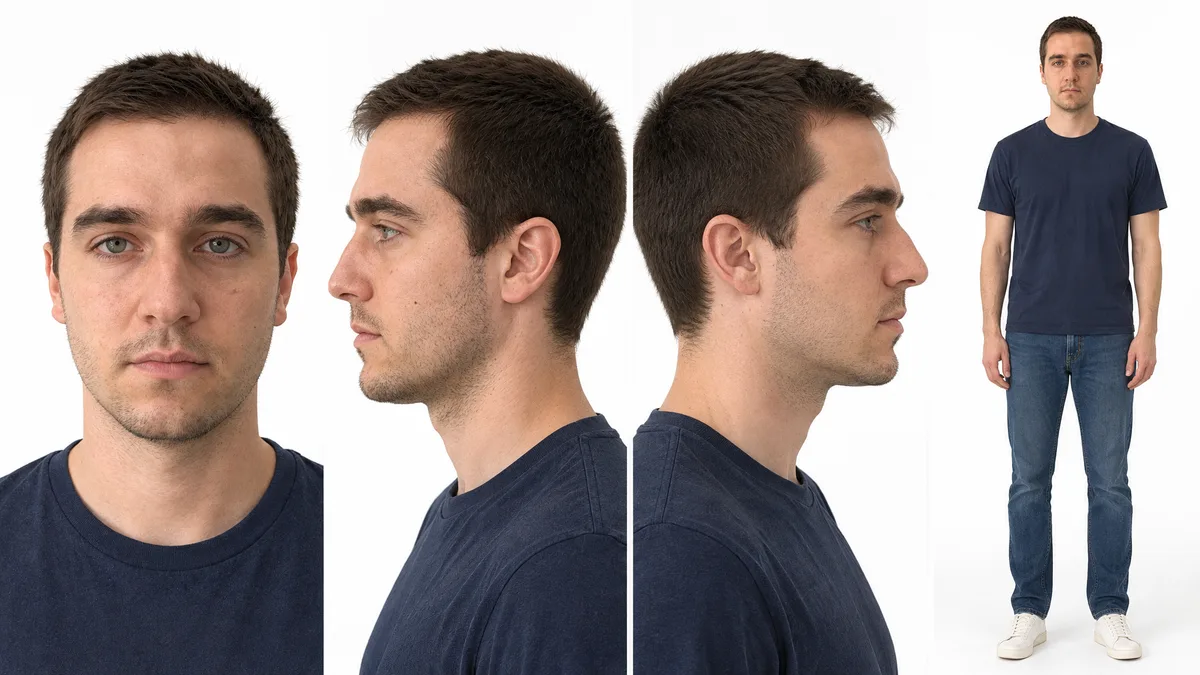
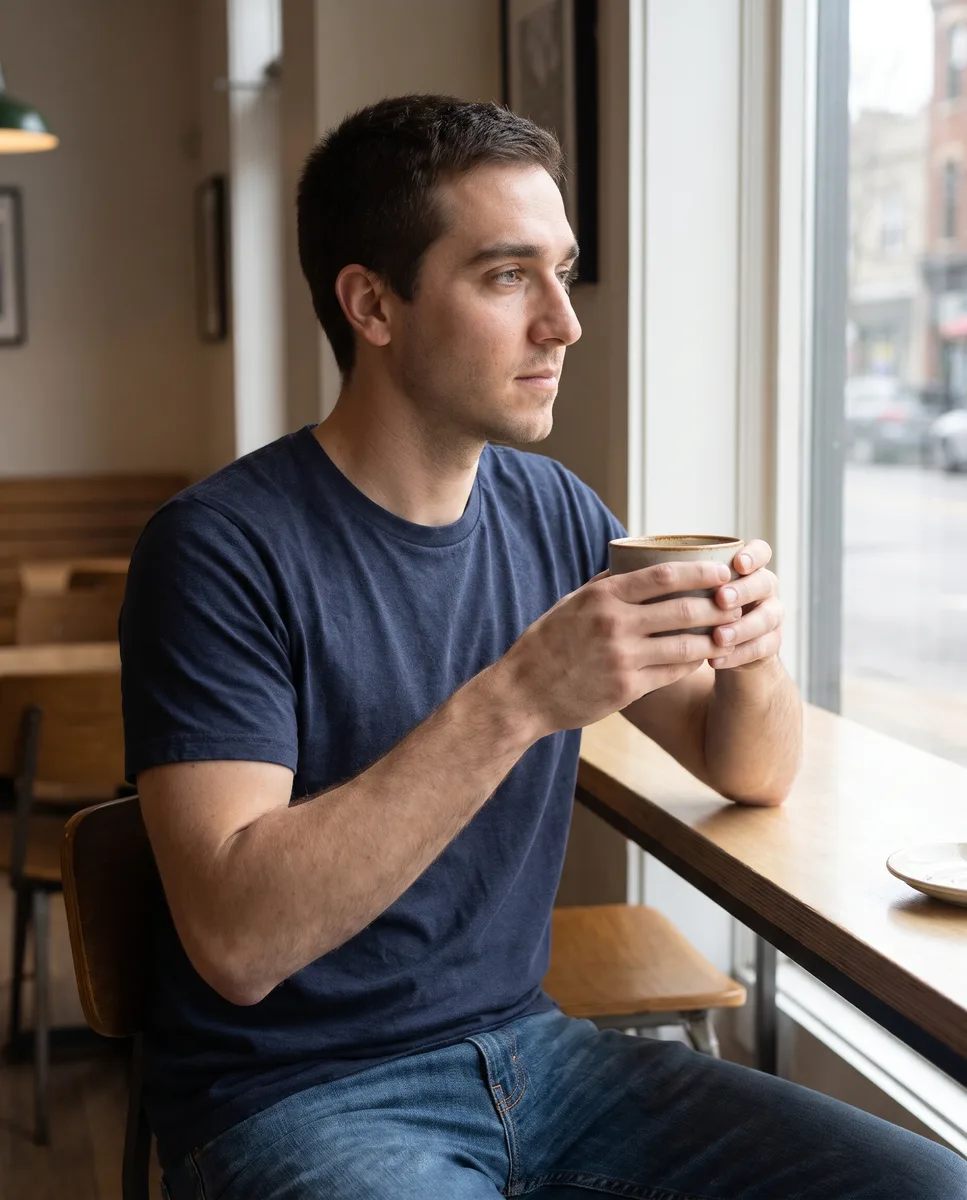
Imagen 1 es la hoja de personaje: cara, peinado y complexión del protagonista. La misma persona está sentada junto a la ventana de una cafetería con una taza en las manos y mira a la calle. Plano medio, objetivo de 50 mm, luz de día suave desde la ventana a la derecha. Una sola persona en el encuadre. Conservar la cara de la imagen 1, sin embellecer, sin piel de plástico.
Imagen 1 es la hoja de personaje del protagonista, imagen 2 es una calle al atardecer. Una sola persona en el encuadre. 0–3 s: plano medio, el protagonista camina por la calle de la imagen 2 hacia la cámara. 3–6 s: primer plano, se detiene y sonríe. La cámara retrocede despacio. Sol bajo desde la izquierda. Conservar la cara y la ropa de la imagen 1, sin embellecer. Sin música.
Imagen 1 es la hoja de personaje del protagonista, audio 1 es su voz. Plano medio, el protagonista está sentado en su escritorio y dice a cámara con la voz del audio 1: «Hola, este es mi doble digital, y la voz es de verdad mía». Cámara fija, luz de ventana desde la izquierda. Conservar la cara de la imagen 1. Sin música.
Precio en monedas
Clon digital: qué fotos hacer para la hoja de personaje
La hoja de personaje es una imagen con varias vistas de la misma persona. Los modelos no recuerdan las generaciones anteriores, así que la hoja va en cada una y la cara se repite a partir de ella.
| Qué fotografiar | Para qué |
|---|---|
| Retrato de frente, expresión neutra | La fuente principal de los rasgos |
| Perfil | Sin él, el modelo inventa la vista lateral |
| Cuerpo entero | Complexión, altura y cómo sienta la ropa |
| Primer plano de una seña | Lunar, cicatriz o pecas que deban verse |
Fotografía con luz uniforme, sin sombras duras. Para ti con otra edad u otro estilo, haz una hoja aparte.
Una copia digital de una persona en fotos y en video
Las fotos y el video los hacen modelos distintos, pero la misma hoja de personaje sirve para ambos.
| Tarea | Modelo | Fotos de entrada |
|---|---|---|
| Serie de fotos | GPT Image 2.6 | Hasta 16 |
| Serie de fotos | Nano Banana Pro | Hasta 8 |
| Clip de hasta 30 segundos | Seedance 2.5 | Hasta 30 |
| Clip de hasta 30 segundos | Wan 3.0 | Hasta 10 |
| Clip de hasta 15 segundos | Seedance 2.0, MiniMax H3 | Hasta 9 |
Varios planos caben en un prompt con marcas de tiempo: funciona en Seedance 2.0 y 2.5, Wan 3.0 y MiniMax H3.
Cómo mantener el parecido en una serie y en un video
Adjunta la misma hoja a cada generación y nómbrala en el texto: imagen 1 es la cara del protagonista. Una referencia sin nombre el modelo puede ignorarla.
Haz cada variante desde la hoja o desde la foto original. Si partes de un resultado ya editado, las desviaciones se acumulan en cada paso.
Mantén la cara grande: plano medio o primer plano. Describe la luz de la escena — de dónde le llega a la cara —, o la hoja hecha en estudio parecerá pegada. Añade no embellecer la cara para que el modelo no suavice la piel.
Tu propia voz como referencia de audio
La voz se da con una referencia de audio. Seedance 2.0 y 2.5 y MiniMax H3 aceptan la grabación solo junto con una foto o un video; Wan 3.0 también sin ellos. Un fragmento de 2 a 15 segundos sirve para todos estos modelos.
Nombra la grabación en el prompt y deja tiempo a la frase: una corta necesita unos tres segundos. El idioma del habla lo marca el texto de la frase. Gemini Omni, Kling 4.0 y Veo 3.1 no aceptan subir audio.
Usa tu propia cara y voz, o las de otra persona solo con su permiso.
Qué rompe el parecido
Una cara pequeña en plano general, una cara de perfil sin vista lateral en la hoja y los accesorios pequeños en la hoja son lo que peor transmite el modelo. Quita de la hoja lo que no deba salir en el encuadre.
Si las vistas de la hoja mezclan tus rasgos o las expresiones deforman la cara, vuelve a un solo retrato neutro y da la ropa y el lugar en fotos aparte. No habrá copia exacta: revisa el principio, el medio y el final del clip y repite el trozo fallido.
Con qué modelo hacerlo


Preguntas frecuentes
¿Cómo se hace un doble digital?
Haz un retrato de frente, un perfil y una foto de cuerpo entero, crea con ellos una hoja de personaje en GPT Image 2.6 o Nano Banana Pro y adjúntala a cada generación de fotos y video. Para la voz, añade tu grabación como referencia de audio.
¿Cómo creo un doble con IA con mi propia voz?
Graba un fragmento de tu voz y añádelo como referencia de audio junto con la hoja de personaje en Seedance 2.5, Wan 3.0 o MiniMax H3. En el prompt indica que el protagonista habla con la voz del audio 1 y pon la frase entre comillas.
¿Se puede hacer una copia exacta de uno mismo con IA?
No habrá copia exacta: los modelos no se entrenan con tus fotos, siguen tu aspecto a partir de referencias. Una hoja de personaje con fotos nítidas y luz uniforme da el resultado más parecido.
¿Por qué mi doble cambia de un fotograma a otro?
Casi siempre porque la hoja de personaje no se adjuntó a todas las generaciones o no se nombró en el prompt. Los modelos no recuerdan lo anterior: el aspecto solo se sostiene con referencias.
¿En qué se diferencia un doble con IA de un avatar con IA?
Un avatar es un retrato que habla a partir de una foto y una grabación de voz. Un doble es tu aspecto y tu voz en cualquier escena, en fotos y en video.