 Mixer AI




Cómo hacer un video con avatar IA a partir de una foto y tu voz
Un avatar digital, o retrato que habla, es un personaje, creado con una foto y una grabación de voz: el modelo anima el retrato y mueve los labios con el sonido. En Mixer AI lo hacen Kling AI Avatar, Kling AI Avatar v2 y OmniHuman 2.0, y el clip dura lo mismo que el audio.
Más
¿Necesitas tu aspecto en escenas distintas, en fotos y video? Es otra guía: Cómo hacer tu gemelo digital: una copia de ti en fotos y video.
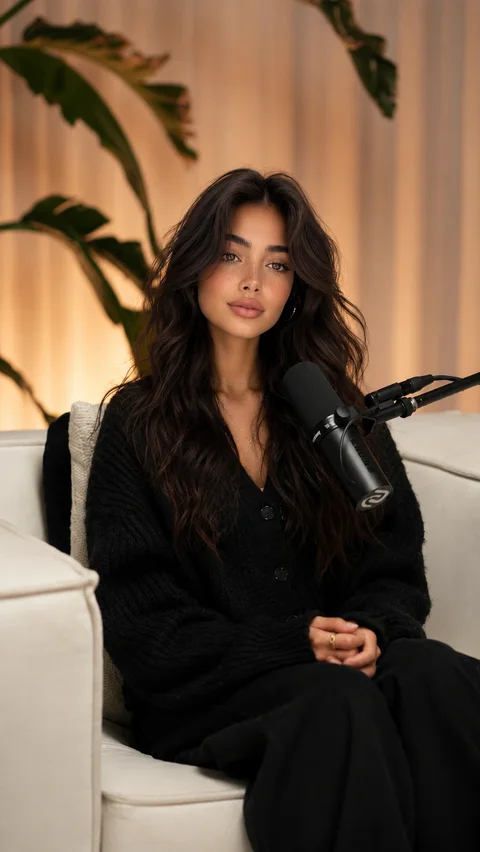
La chica está sentada en un sofá junto a un micrófono y habla con calma a cámara, inclina un poco la cabeza y gesticula con ambas manos, sonriendo con suavidad en las pausas. El torso casi no se mueve. Plano medio, cámara fija. La luz cálida y suave, la cortina, la planta y el micrófono de la foto no cambian.
Paso a paso
Prepara el audio: graba tu voz en una habitación silenciosa o locuta el texto en el lienzo con ElevenLabs.
Quita el ruido, revisa nombres, pronunciación y pausas, y recorta los silencios del principio y del final: la duración del clip y el precio dependen del audio.
Elige modelo: Kling AI Avatar o Kling AI Avatar v2 — Standard para probar, Pro para el final; OmniHuman 2.0 cuando quieras movimiento del cuerpo con el sonido, con audio MP3 o WAV desde 4 segundos.
Sube la foto y el audio.
Añade un prompt corto sobre la actitud: emoción, gestos, posición de cámara.
Haz el primer clip con una frase corta y revisa labios, mentón y final de la frase.
Prompts para avatar con IA
La persona habla a cámara con seguridad y una leve sonrisa, y levanta un poco las cejas en las palabras clave. La cabeza casi inmóvil, los hombros relajados. Primer plano, cámara fija.
El personaje canta, balancea suavemente la cabeza al ritmo y cierra los ojos en las notas largas. Plano medio, cámara fija, el fondo de la foto no cambia.
Precio en monedas
Video con avatar IA: qué modelo elegir
Los tres modelos toman una foto y un audio y hacen un clip tan largo como la grabación. Se diferencian en el formato de audio y en cómo se mueve el cuerpo.
| Modelo | Audio | Qué importa |
|---|---|---|
| Kling AI Avatar | Hasta 5 minutos, hasta 100 MB | Habla y canta; Standard y Pro |
| Kling AI Avatar v2 | Hasta 5 minutos; MP3, WAV, AAC, M4A, MP4, OGG | Standard para borradores, Pro para el final; prompt opcional |
| OmniHuman 2.0 | MP3 o WAV, de 4 segundos a 5 minutos, hasta 15 MB | Clip en 720p, movimiento del cuerpo con el sonido |
Duración, resolución y proporción no se eligen: el clip sigue la duración del audio y el encuadre de la foto.
Crear un avatar con IA: qué foto sirve
Funciona mejor un retrato de frente nítido, con la cara ocupando buena parte del encuadre y luz uniforme. Cara pequeña, sombras, gafas o cabeza girada perjudican los labios y el parecido.
También sirve una ilustración con la cara bien visible. Si necesitas el mismo personaje en muchas escenas, haz primero su hoja de personaje: eso lo explica la guía del gemelo digital.
La voz: cómo hacer que una foto hable
Lo más directo es grabar la voz tú mismo: sin ruido y con pausas donde hagan falta. Usa tu propia cara y voz, o las de otra persona solo con su permiso.
Si necesitas un locutor, locuta el texto en el lienzo con ElevenLabs: eliges voz, ritmo y estabilidad, y en un diálogo cada intervención tiene su voz. Procesa a cada hablante en un clip aparte y únelos en edición.
Cómo animar un retrato sin deformaciones
El canto y la música fuerte cuestan más a los labios que el habla: para una canción usa una pista con voz clara. Varias voces en una grabación desajustan la sincronización.
Si la cara se deforma en el clip, empieza con una foto más nítida y un prompt tranquilo, sin giros bruscos de cabeza. Revisa el principio, el medio y el final del clip.
Con qué modelo hacerlo

Preguntas frecuentes
¿Cómo se crea un avatar con IA?
Sube un retrato de frente y una grabación de voz a Kling AI Avatar, Kling AI Avatar v2 u OmniHuman 2.0 y, si quieres, añade un prompt corto sobre la actitud. El modelo hace un clip tan largo como el audio, hasta 5 minutos.
¿Cómo hago un avatar con IA con mi propia voz?
Graba tu voz en una habitación silenciosa y sube el archivo con la foto. Los modelos de avatar mueven los labios con cualquier grabación, no hace falta ajustar la voz.
¿Puedo introducir texto en vez de audio?
Los modelos de avatar solo aceptan audio terminado. Locuta primero el texto en el lienzo con ElevenLabs y sube el archivo resultante.
¿Puede cantar un avatar que habla hecho con una foto?
Sí, sube una pista con voz clara. Varias voces y un acompañamiento fuerte dificultan la sincronización de los labios.
¿Cómo hago una conversación entre dos retratos que hablan?
Haz un clip aparte para cada hablante con su foto y sus frases, y luego une las intervenciones en edición.