 Mixer AI




Как создать цифровой аватар нейросетью: говорящий персонаж из фото
Говорящий аватар — ролик из одного фото и записи голоса: нейросеть двигает губы портрета под звук. Ролик длится столько же, сколько аудио.
Подробнее
Цифровой аватар, или говорящий портрет, — персонаж из одного фото и записи голоса: нейросеть оживляет портрет и двигает губы под звук. В Mixer AI такой ИИ-аватар делают Kling AI Avatar, Kling AI Avatar v2 и OmniHuman 2.0, а ролик длится столько же, сколько аудио. Нужна ваша внешность в разных сценах на фото и в видео — это отдельная инструкция „Как сделать цифрового двойника человека по своим фото и голосу“.
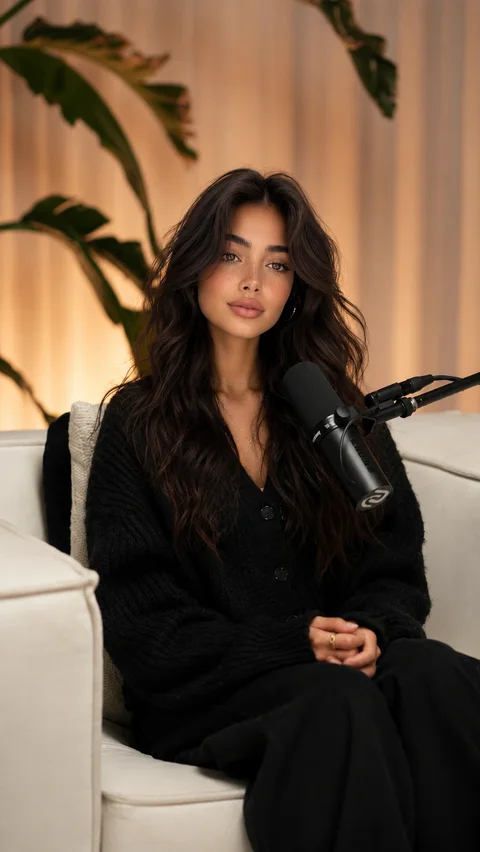
Девушка сидит на диване у микрофона и спокойно говорит в камеру, слегка наклоняет голову и жестикулирует обеими руками, в паузах мягко улыбается. Корпус почти неподвижен. Средний план, камера неподвижна. Тёплый мягкий свет, штора, растение и микрофон с фото не меняются.
Пошагово
Возьмите чёткий портрет анфас при ровном свете.
Выберите портрет анфас или почти анфас при ровном свете: лицо крупно, волосы, руки и предметы не закрывают рот, вокруг головы есть немного места.
Запишите речь в тишине или озвучьте текст в ElevenLabs, обрежьте паузы по краям.
Подготовьте звук: запишите речь в тихой комнате или озвучьте текст на холсте в ElevenLabs. Уберите лишний шум, проверьте имена, ударения и паузы, обрежьте тишину в начале и конце — длина ролика и цена зависят от длины аудио.
Выберите модель и загрузите фото и аудио.
Выберите модель: Kling AI Avatar или Kling AI Avatar v2 — Standard для проверки, Pro для итога; OmniHuman 2.0 — когда нужно движение тела под звук, аудио в MP3 или WAV от 4 секунд. Загрузите фото и аудио.
Опишите в промпте манеру: эмоцию, жесты, камеру. Первый ролик — на короткой фразе.
Допишите короткий промпт о манере: эмоция, жесты, положение камеры. Первый ролик сделайте на короткой фразе и проверьте губы, подбородок и конец реплики.
Запись длиннее 5 минут делите на части и собирайте в монтаже.
Текст длиннее 5 минут разбейте на части, сделайте ролик на каждую с тем же фото и соберите их в монтаже.
Промпты для ИИ-аватара
Человек говорит в камеру уверенно, с лёгкой улыбкой, на важных словах чуть приподнимает брови. Голова почти неподвижна, плечи расслаблены. Крупный план, камера неподвижна.
Персонаж поёт, плавно покачивает головой в такт, на долгих нотах прикрывает глаза. Средний план, камера неподвижна, фон с фото не меняется.
Цена в монетах
Аватар видео ИИ: какую модель выбрать
Все три модели берут одно фото и одно аудио и делают ролик длиной в запись. Разница — в формате звука и в том, как двигается тело.
| Модель | Аудио | Что важно |
|---|---|---|
| Kling AI Avatar | До 5 минут, до 100 МБ | Говорит и поёт; варианты Standard и Pro |
| Kling AI Avatar v2 | До 5 минут; MP3, WAV, AAC, M4A, MP4, OGG | Standard для черновика, Pro для итога; промпт необязателен |
| OmniHuman 2.0 | MP3 или WAV, от 4 секунд до 5 минут, до 15 МБ | Ролик в 720p, движение тела под звук |
Длительность, разрешение и пропорции не выбираются: ролик повторяет длину аудио и кадр фото.
Создание ИИ-аватара: какое фото подойдёт
Лучше всего работает чёткий портрет анфас, где лицо занимает заметную часть кадра и освещено ровно. Мелкое лицо, тени, очки и поворот головы мешают губам и сходству.
Подойдёт и иллюстрация с ясно видимым лицом. Если один и тот же персонаж нужен во многих сценах, сначала соберите его лист персонажа — об этом инструкция про ИИ-двойника.
Голос: как заставить фото говорить
Самый прямой способ — записать речь самому: без шума, с паузами там, где они нужны. Используйте своё лицо и голос или чужие — с разрешения этого человека.
Если нужен диктор, озвучьте текст на холсте в ElevenLabs: там выбирают голос, темп и стабильность подачи, а для диалога задают отдельный голос каждой реплике. Каждого спикера обрабатывайте отдельным роликом и соединяйте в монтаже.
Как оживить портрет без искажений
Пение и громкая музыка даются губам хуже речи: для песни берите дорожку с отчётливым вокалом. Несколько голосов в одной записи сбивают синхронизацию.
Если лицо в ролике поплыло, начните с более чёткого фото и спокойного промпта без резких поворотов головы. Проверяйте начало, середину и конец ролика.
Чем сделать — модели

Частые вопросы
Как создать ИИ-аватар?
Загрузите портрет анфас и запись речи в Kling AI Avatar, Kling AI Avatar v2 или OmniHuman 2.0 и при желании допишите короткий промпт о манере. Модель сделает ролик длиной в аудио, до 5 минут.
Как сделать ИИ-аватар со своим голосом?
Запишите речь в тихой комнате и загрузите файл вместе с фото. Модели аватара двигают губы под любую запись, отдельной настройки голоса не нужно.
Можно ввести текст вместо аудио?
Модели аватара принимают только готовый звук. Текст сначала озвучивают на холсте в ElevenLabs, затем загружают получившийся файл.
Может ли говорящий аватар из фото петь?
Да, загрузите дорожку с отчётливым вокалом. Несколько голосов и громкий аккомпанемент усложняют синхронизацию губ.
Как сделать диалог двух говорящих портретов?
Сделайте отдельный ролик для каждого спикера с его фото и его репликами, затем соберите реплики в монтаже.