 Mixer AI




Как сделать цифрового двойника человека по своим фото и голосу
ИИ-двойник, он же AI-двойник или ИИ-клон, — это ваше лицо и внешность, которые держатся от кадра к кадру на фото и в видео, плюс ваш голос. Такой клон себя собирают нейросетью из листа персонажа по своим фотографиям и прикладывают его референсом к каждой генерации: своей модели под ваше лицо здесь не обучают, поэтому сходство зависит от исходников.
Подробнее
Нужен говорящий аватар из одного фото и записи голоса — это отдельная инструкция „Как создать цифровой аватар нейросетью: говорящий персонаж из фото“.
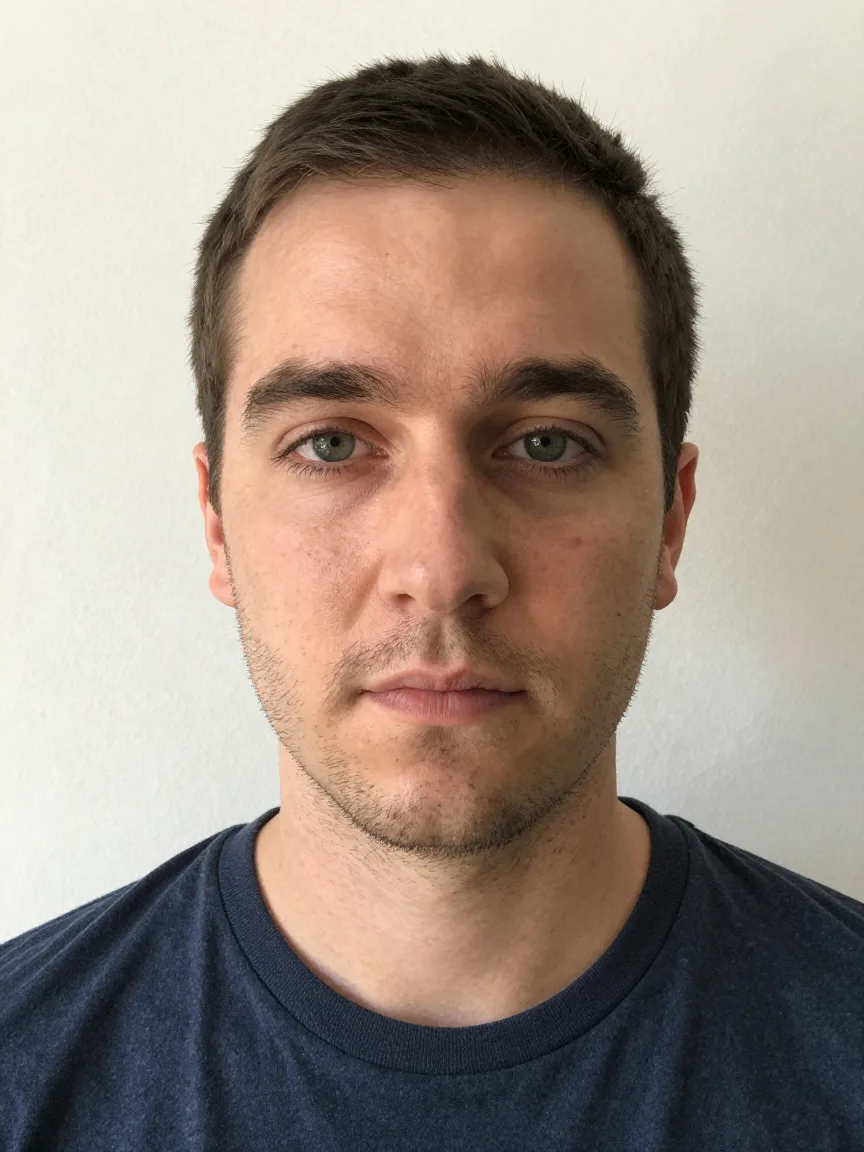
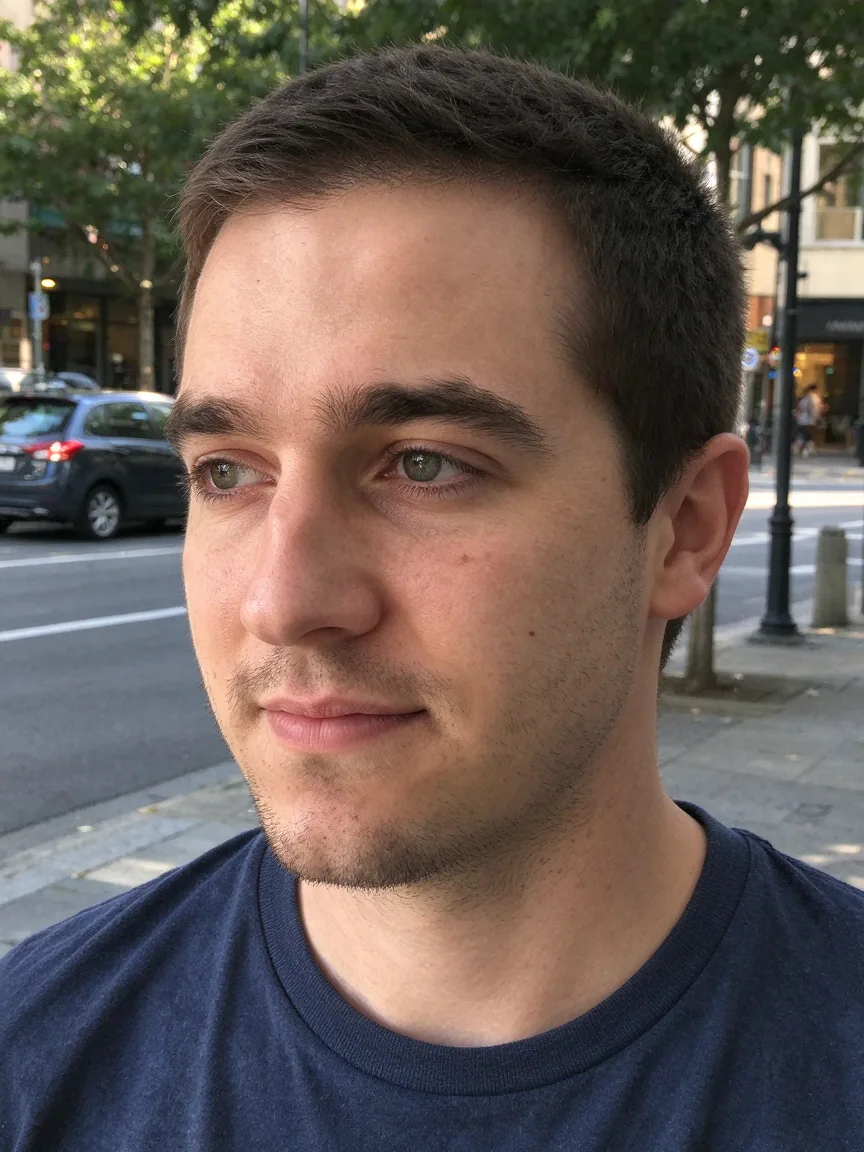
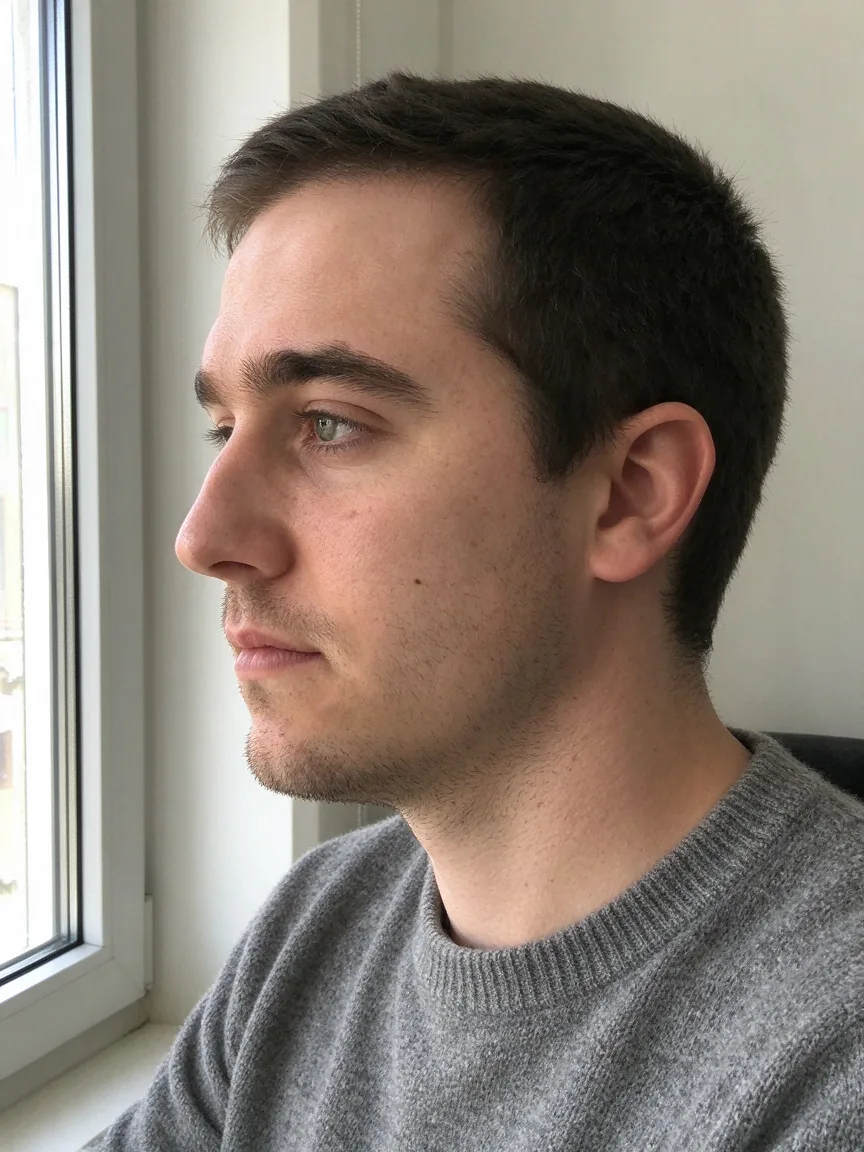
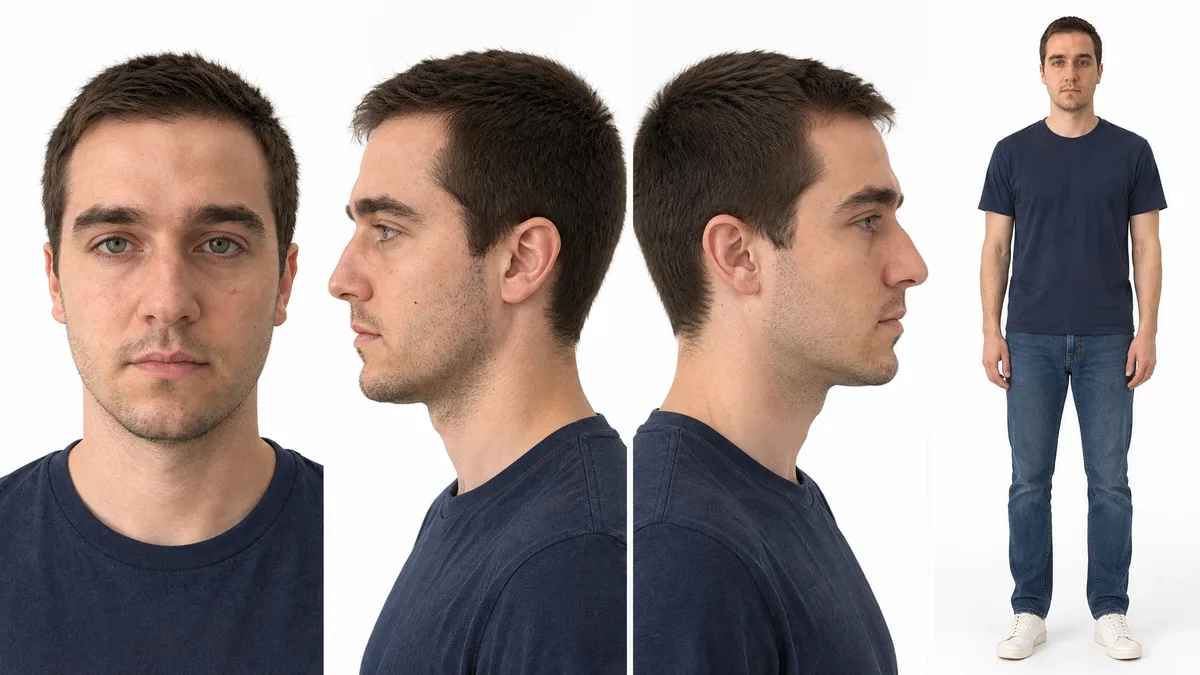
Лист персонажа по фото 1–3: один и тот же человек в четырёх видах — портрет анфас, профиль слева, профиль справа, в полный рост. Чистый белый фон, ровный мягкий свет, фотореализм, нейтральное выражение лица. Сохранить черты лица, форму носа, цвет глаз, линию волос, родинки и веснушки как на исходных фото. Не украшать лицо, не менять возраст, без аксессуаров и надписей.
Пошагово
Снимите исходники при ровном дневном свете: портрет анфас с нейтральным лицом, профиль, снимок в полный рост.
Без очков и головного убора; если важны родинки или шрам, добавьте крупный план.
Соберите лист персонажа в GPT Image 2.6 или Nano Banana Pro: загрузите свои фото и попросите три-четыре вида одного человека на белом фоне.
Сравните с собой и переделайте, если поплыли нос, глаза или линия волос.
Для серии фото прикладывайте лист к каждому кадру и описывайте только сцену, свет и позу.
Каждый новый кадр делайте от листа, а не от предыдущего результата.
Для видео выберите Seedance 2.5 или Wan 3.0 в режиме по референсам, загрузите лист и фото места.
В промпте назовите роли («фото 1 — лицо и одежда героя, фото 2 — улица») и число людей в кадре.
Чтобы двойник говорил вашим голосом, запишите отрывок речи на 2–15 секунд в тихой комнате и добавьте его аудио-референсом в Seedance 2.0 или 2.5, Wan 3.0 или MiniMax H3.
В промпте напишите «говорит голосом из аудио 1» и саму реплику в кавычках.
Промпты для цифрового двойника
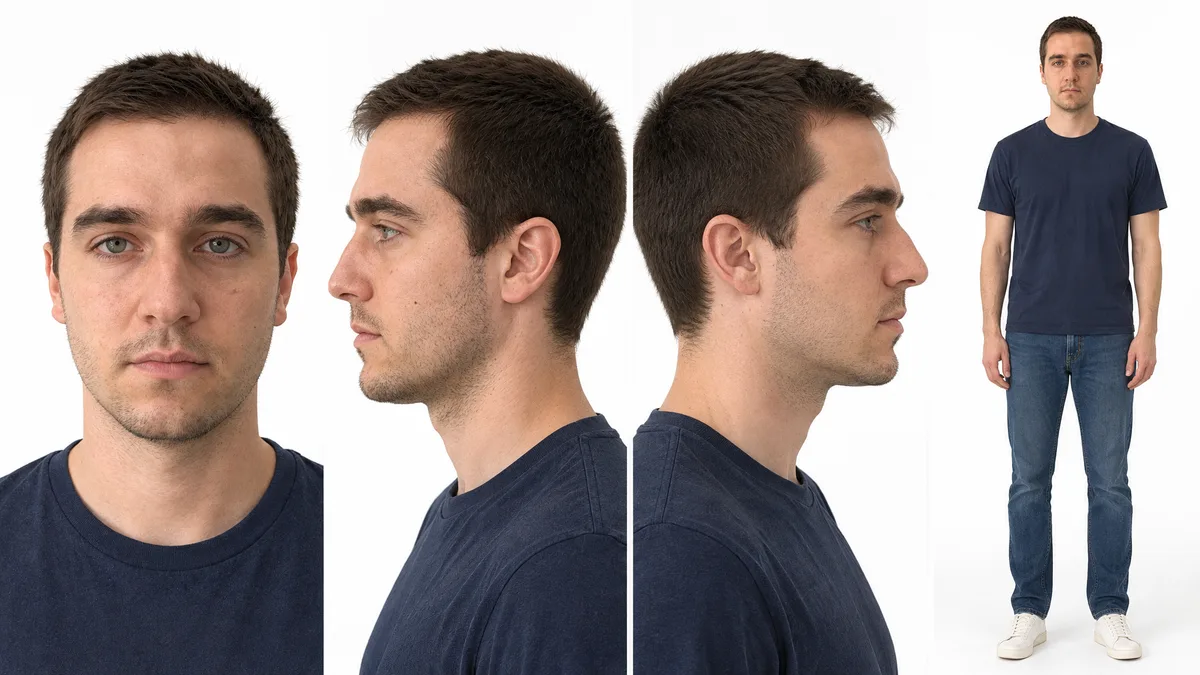
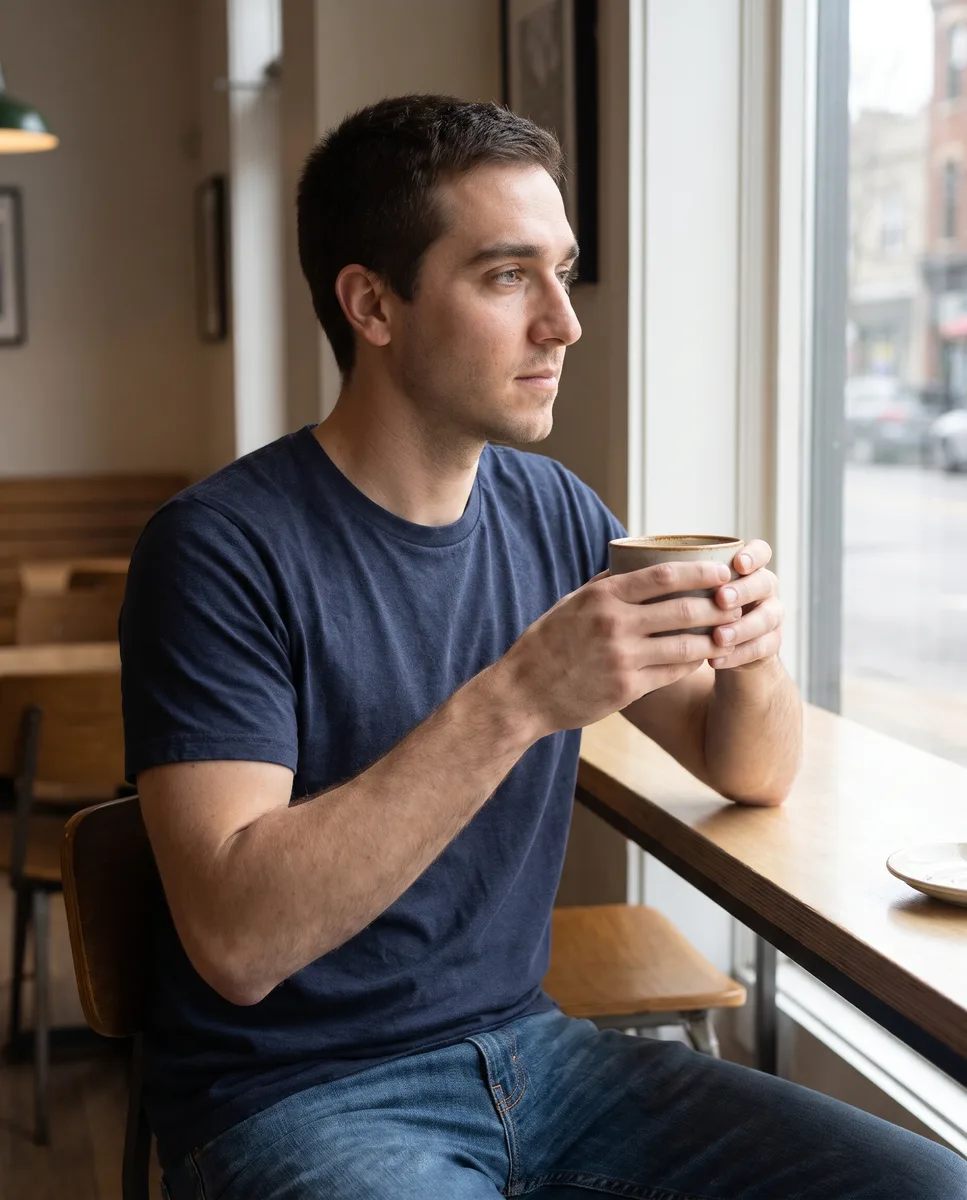
Фото 1 — лист персонажа: лицо, причёска и телосложение героя. Тот же человек сидит у окна в кафе с чашкой в руках и смотрит на улицу. Средний план, объектив 50 мм, мягкий дневной свет из окна справа. Один человек в кадре. Сохранить лицо с фото 1, не украшать, без пластиковой кожи.
Фото 1 — лист персонажа героя, фото 2 — вечерняя улица. Один человек в кадре. 0–3 с: средний план, герой идёт по улице с фото 2 навстречу камере. 3–6 с: крупный план, он останавливается и улыбается. Камера плавно отъезжает назад. Свет низкого солнца слева. Сохранить лицо и одежду с фото 1, не украшать. Без музыки.
Фото 1 — лист персонажа героя, аудио 1 — его голос. Средний план, герой сидит за рабочим столом и говорит в камеру голосом из аудио 1: «Привет, это мой цифровой двойник, а голос — мой настоящий». Камера неподвижна, свет из окна слева. Сохранить лицо с фото 1. Без музыки.
Цена в монетах
Цифровой клон: какие фото снять для листа персонажа
Лист персонажа — одна картинка с несколькими видами одного человека. Модели не помнят прошлые запуски, поэтому лист прикладывают к каждой генерации, и по нему они повторяют лицо.
| Что снять | Зачем |
|---|---|
| Портрет анфас, нейтральное лицо | Главный источник черт лица |
| Профиль | Без него лицо сбоку модель додумывает |
| Полный рост | Телосложение, рост, посадка одежды |
| Крупный план приметы | Родинка, шрам, веснушки, если они должны быть в кадре |
Снимайте при ровном свете без сильных теней. Для себя в другом возрасте или образе сделайте отдельный лист.
Цифровая копия человека на фото и в видео
Фото и видео делают разные модели, но лист персонажа подходит обеим.
| Задача | Модель | Сколько фото на входе |
|---|---|---|
| Серия фото | GPT Image 2.6 | До 16 |
| Серия фото | Nano Banana Pro | До 8 |
| Ролик до 30 секунд | Seedance 2.5 | До 30 |
| Ролик до 30 секунд | Wan 3.0 | До 10 |
| Ролик до 15 секунд | Seedance 2.0, MiniMax H3 | До 9 |
Несколько планов можно описать в одном промпте по таймкодам: так работают Seedance 2.0 и 2.5, Wan 3.0 и MiniMax H3.
Как удержать сходство в серии и в ролике
Прикладывайте один и тот же лист к каждой генерации и называйте его в тексте: «фото 1 — лицо героя». Безымянный референс модель может пропустить.
Делайте каждый вариант от листа или исходного фото. Если взять за основу уже изменённый результат, отклонения копятся с каждым шагом.
Держите лицо крупно: средний или крупный план. Пропишите свет сцены — откуда он падает на лицо, — иначе снятый в студии лист выглядит вклеенным. Добавьте «не украшать лицо», чтобы модель не сглаживала кожу.
Свой голос как аудио-референс
Голос задают аудио-референсом. Seedance 2.0 и 2.5 и MiniMax H3 принимают запись только вместе с фото или видео, Wan 3.0 — и без них. Отрывок на 2–15 секунд подойдёт всем этим моделям.
Назовите запись в промпте и дайте реплике время: короткой фразе нужно около трёх секунд. Язык речи задаётся текстом реплики. Gemini Omni, Kling 4.0 и Veo 3.1 загрузку аудио не принимают.
Используйте своё лицо и голос или чужие — с разрешения этого человека.
Что ломает сходство
Мелкое лицо на общем плане, лицо в профиль без бокового вида на листе, мелкие аксессуары на листе — всё это модель передаёт хуже всего. Лишние вещи с листа уберите, если их не должно быть в кадре.
Если виды на листе смешали черты или эмоции исказили лицо, вернитесь к одному нейтральному портрету и давайте одежду и место отдельными фото. Точной копии не будет: проверяйте результат в начале, середине и конце ролика и переделывайте неудачный кусок.
Чем сделать — модели


Частые вопросы
Как сделать цифрового двойника?
Снимите портрет анфас, профиль и полный рост, соберите из них лист персонажа в GPT Image 2.6 или Nano Banana Pro и прикладывайте его к каждой генерации фото и видео. Для голоса добавьте свою запись аудио-референсом.
Как создать ИИ-двойника со своим голосом?
Запишите отрывок речи и добавьте его аудио-референсом вместе с листом персонажа в Seedance 2.5, Wan 3.0 или MiniMax H3. В промпте напишите, что герой говорит голосом из аудио 1, и дайте реплику в кавычках.
Можно ли сделать ИИ-копию себя один в один?
Точной копии не будет: модели не обучаются на ваших фото, а повторяют внешность по референсам. Ближе всего к вам результат с листом персонажа из чётких фото при ровном свете.
Почему двойник меняется от кадра к кадру?
Чаще всего потому, что лист персонажа приложили не ко всем генерациям или не назвали в промпте. Модели не помнят прошлые запуски: внешность держится только на референсах.
Чем ИИ-двойник отличается от ИИ-аватара?
ИИ-аватар — говорящий портрет из одного фото и записи голоса. ИИ-двойник — ваша внешность и голос в любых сценах на фото и в видео.